我在短视频平台下载了搞笑段子的音频,想着用我本地部署的MiniMax H3来生成对应的画面,结果卡在对口型上了。
AI经常生成含糊不清的话,或者是突然没声,一开始我还以为是本地的MiniMax H3本来就不擅长这个,但事实并非如此。
本地 ComfyUI 的节点定义里 Ref2VA 除了参考图/参考视频,还有一路音频输入,只要把对白音频整段喂给模型,就能按音频本身驱动唇形。
最终的效果如下:
我把这些做成了一个技能包
踩完这些坑,后面workbuddy上下文一压缩,连上次是怎么解决的都想不起来,下次做片子还得重踩一遍。
所以我把它们做成了一个 skill,名字叫 h3-lipsync。它是一份给 AI 助手读的工作手册,加两个脚本。
装好之后,你说"这段视频的嘴对不上",助手就会照着这套方法接线、写提示词、验收、合成,不会自己从零发明。
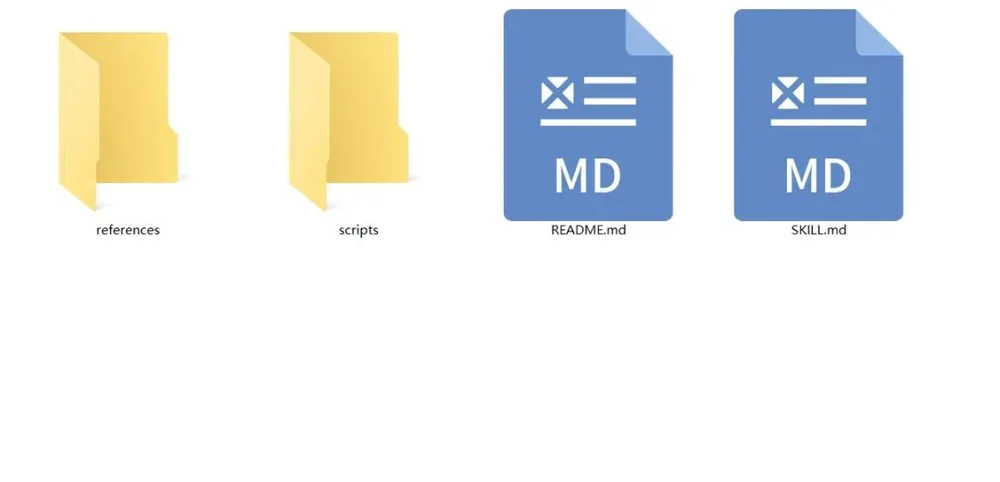
skill里面装了这些东西
一份流程入口
核心原则写在最前面,只有一句。要配音的镜头,把对白整段喂进去。
后面是五步流程和一张症状速查表,比如"台词响了嘴才动"对应什么,"谁说都在动"对应什么。
五篇参考资料
ComfyUI 怎么接线、官方提示词格式和三条必写约束、八个坑连同实测数据、验收方法学、连读对白的时间轴怎么校准。
其中一篇专门讲切幕,因为连读的吵架对白用滑动窗识别会把句起点算早 0.4 到 0.8 秒,切出来的幕台词会跑到上一幕去。
两个脚本
lipcheck.py 量嘴有没有对上。给它一段视频、一份时间轴 CSV、两个嘴部框的坐标,它算出滞后和比值,直接给判定。时间轴每行一句,写明起止秒数和说话人。
mix_audio.py 负责合成。它强制走两步法,跑完会自己打印三项时长断言。
三项对不上会直接告警,不让这种片子悄悄流出去。
什么人适合用,什么人别用
适合三类人用。
在做 AI 短剧的人
有对白,要分幕,嘴对不上就没人看得下去,这套方法把对上这件事从试错变成了流程。
用 AI 助手生成 ComfyUI 工作流的人
这是我最想给的一群人。你跟助手说"帮我接个 H3 的对口型",它大概率会编一套听起来合理但没验证过的参数。给它一份手册,它就能照着做对。
是已经被坑过一次的人
如果你的片子出现过观众听几秒就没声,或者嘴一直在动但谁都没对上,这里大概率有你要的答案。
怎么用这个skill
直接把skill的压缩包拖进AI agent(workbuddy或豆包工作之类的都行),让AI agent安装一下。
之后正常跟AI agent说话就好,比如下面这样:
❝
我有一段 30 秒的对白音频,想用 H3 做成三幕短剧,嘴要对上。
同时把音频也把音频也喂给AI agent就好了。